José Miguel Amaya — construyendo con LLMs
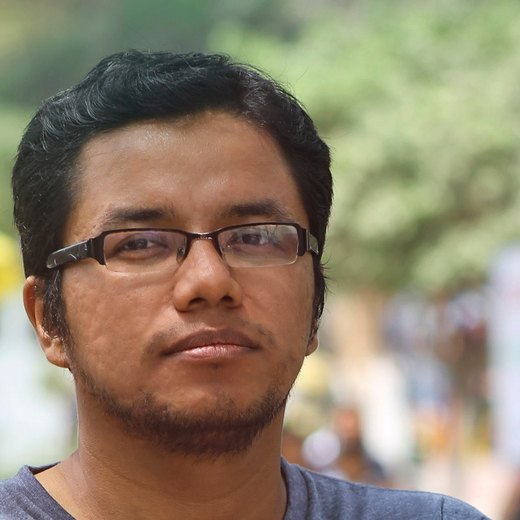
- CTO y socio fundador de Xprende Tech. Full Stack Engineer en Efilm Online.
- Fundador de Piura AI, Tallanix, Python Piura y VICUX.
- Especialista en Python, Django/FastAPI e IA (LangChain, LangGraph, RAG).
- Autor de charlas y talleres de IA aplicada en Python Piura y Piura AI.
“¿Quién ha peleado con un bot de soporte hecho con LLMs?”
La salida cambia un carácter y tu parser se rompe.
Responde políticas que no son las de tu empresa.
No consulta el pedido ni ejecuta una devolución.
Hoy resolvemos esto construyendo SoporteBot, pieza por pieza.
Al terminar podrás…
- Crear un chat model y componerlo con promptsmodelos
- Forzar salidas estructuradas para clasificar y extraerdatos
- Montar búsqueda semántica y una cadena RAGconocimiento
- Construir un agente con herramientas, memoria y middlewareagentes
¿Qué son los LLMs?
Los modelos de lenguaje a gran escala son modelos de machine learning que sobresalen en tareas relacionadas con el lenguaje: generación de texto, traducción, resumen, respuesta a preguntas, entre otras.
Suelen usarse a través de una interfaz de modelo de chat: recibe una lista de mensajes y devuelve un mensaje como salida.
Mensajes
system · user · assistant · toolModelo
procesa el contextoRespuesta
texto o llamada a herramientaCapacidades de los LLMs modernos
Interactuar con APIs, servicios y bases de datos. Base de SoporteBot para consultar pedidos.
Responder con un formato que cumple un esquema. Útil para clasificar tickets.
Trabajar con imágenes, audio y video, además de texto.
¿Qué es LangChain?
Es un framework para desarrollar aplicaciones basadas en LLMs. Simplifica cada etapa del ciclo de vida de la aplicación y da una interfaz uniforme para trabajar con modelos de distintos proveedores.
Cambiar de OpenAI a Anthropic es cambiar una línea.
Encadenar prompts, modelos y herramientas con el operador |.
Monitorear, depurar y optimizar en producción.
Anatomía de SoporteBot
Toda aplicación se arma con las mismas piezas: un modelo que razona, herramientas que ejecutan acciones y un prompt que da contexto.
Lee el ticket y decide qué hacer.
Consultar pedidos o buscar en el manual.
Políticas, historial y conocimiento recuperado.
Todo se compone: los Runnables
Prompts, modelos y parsers son Runnables: piezas con los mismos métodos que se encadenan con el operador |. Esto es LCEL, el Lenguaje de Expresión LangChain.
cadena = prompt | model | StrOutputParser()   # todos son Runnables

cadena.invoke(datos)            # una vez
cadena.batch([d1, d2])          # en lote
for c in cadena.stream(datos):  # en vivo
    print(c, end="")
La misma cadena tiene invoke, stream y batch sin escribir nada extra.
El ecosistema LangChain
Mensajes, prompts, herramientas, parsers y Runnables (LCEL).
Un paquete por proveedor o tecnología (OpenAI, MongoDB…).
create_agent, mensajes, tools, modelos y embeddings.
LangGraph, despliegue y LangSmith
Modela pasos como nodos y bordes. Base de create_agent; también se usa por separado.
Lleva a producción aplicaciones con estado, con persistencia y escalado.
Depurar, probar, evaluar y monitorear aplicaciones LLM.
El modelo de chat
- init_chat_model("proveedor:modelo") crea un modelo de cualquier proveedor con una sola función.
- Por debajo, cada proveedor expone una clase con prefijo “Chat”: ChatOpenAI, ChatAnthropic, ChatOllama.
- Todas heredan de BaseChatModel: misma interfaz de streaming, asincronía y batching.
model = init_chat_model("gpt-5-nano", model_provider="openai", temperature=0)

model.invoke("Resume este ticket: mi pedido no llegó.")   # una respuesta

for chunk in model.stream("Escribe una disculpa breve."):
    print(chunk.text, end="")                              # streaming en vivo

model.batch(["Hola", "Gracias", "Adiós"]) # varias a la vezParámetros estándar
El modelo específico, por ejemplo gpt-5-nano o claude-sonnet-4-6.
Bajo = respuestas consistentes. Alto = respuestas variadas.
Cota superior de la longitud de la respuesta.
Métodos principales
Mensajes en código
from langchain.messages import (
    SystemMessage, HumanMessage, AIMessage)

mensajes = [
    SystemMessage("Eres el soporte de TiendaPiura."),
    HumanMessage("Mi pedido #12345 no llegó."),
    AIMessage("Lamento el retraso, lo reviso."),
]mensajes = [
{"role": "system", "content": "Eres el soporte."},
{"role": "user", "content": "Mi pedido no llegó."},
{"role": "assistant", "content": "Lo reviso."},
]El cuarto rol, tool (ToolMessage), lleva el resultado de una herramienta de vuelta al modelo. Lo veremos en agentes.
Prompt Templates
- Transforman la entrada del usuario y parámetros en instrucciones para el modelo.
- Reciben un diccionario donde cada clave rellena una variable.
- Devuelven un PromptValue, que se pasa al modelo; también se puede convertir a string o a lista de mensajes.
Para entradas simples: PromptTemplate.from_template("Resume {ticket}").
Plantillas individuales por rol; es el que usaremos.
MessagesPlaceholder
Inserta una lista de mensajes en un punto específico del prompt. Es la pieza clave para inyectar el historial de una conversación.
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

prompt = ChatPromptTemplate.from_messages([
    ("system", "Eres el soporte de TiendaPiura."),
    MessagesPlaceholder("historial"),
    ("human", "{pregunta}"),
])Redactar la respuesta al cliente
Unimos las piezas: un prompt con variables y una llamada al modelo.
from langchain.chat_models import init_chat_model
from langchain_core.prompts import ChatPromptTemplate

model = init_chat_model("gpt-5-nano", model_provider="openai", temperature=0.3)

prompt = ChatPromptTemplate.from_messages([
    ("system", "Eres el soporte de {tienda}. Responde con empatía y claridad."),
    ("human", "{ticket}"),
])

cadena = prompt | model
cadena.invoke({"tienda": "TiendaPiura", "ticket": "Mi pedido #12345 no ha llegado."})Outputs estructurados
Garantizan que el LLM genere una respuesta que sigue un esquema definido, lo que facilita integrarla en tu aplicación.
Proporcionan respuestas confiables, esenciales cuando dependes de datos estructurados.
Cómo se implementa
Clasificar el ticket
Asignamos etiquetas al ticket según categorías relevantes: categoría, urgencia y sentimiento.
from typing import Literal
from pydantic import BaseModel
from langchain.chat_models import init_chat_model

class Ticket(BaseModel):
    categoria: Literal["envio", "pago", "producto"]
    urgencia: Literal["baja", "media", "alta"]
    sentimiento: Literal["positivo", "neutral", "negativo"]

model = init_chat_model("gpt-5-nano", model_provider="openai", temperature=0)
clasificador = model.with_structured_output(Ticket)
clasificador.invoke("Mi pedido #12345 no ha llegado.")Extraer datos del pedido
Reutilizamos el mismo model y extraemos datos de texto no estructurado.
class Pedido(BaseModel):
    numero: str
    producto: str | None = None
    cliente: str | None = None

extractor = model.with_structured_output(Pedido)

texto = "Ana López pregunta por el pedido #12345 (audífonos)."
datos = extractor.invoke(f"Extrae los datos: {texto}")
print(datos.numero, datos.producto, datos.cliente)Errores comunes
Declara int | None = None; si no, la validación falla.
Para clasificar o extraer usa temperature=0.
Varios esquemas pequeños son más fiables que uno enorme.
Deja que el esquema falle claro en desarrollo, no en producción.
¿Qué es un motor de búsqueda semántica?
Es un sistema que busca y recupera información basada en el significado o contexto de una consulta, no en palabras exactas.
Solo encuentra el manual si aparece esa palabra exacta.
Encuentra la política de reembolsos aunque no use la palabra.
Embeddings: el significado como vector
Un embedding convierte texto en números (un vector). Textos con significado parecido quedan cerca en ese espacio.
La búsqueda compara el vector de la consulta con los de los fragmentos del manual.
Chunking: dividir el manual
Una página es demasiado grande para buscar. La partimos en fragmentos con solapamiento para no cortar ideas.
0–1000
800–1800
1600–2600
2400–3400
El solapamiento (naranja) evita perder frases que cruzan el corte.
Retrieval-Augmented Generation
El modelo usa información recuperada de fuentes externas para responder, combinando su conocimiento general con tus datos. Tres piezas: cargar (Document), vectorizar (embeddings) y almacenar (vector store).
Pregunta
consulta del clienteRecuperar
fragmentos similaresAumentar
inyectar en el promptGenerar
respuesta con contextoCargar y dividir el manual
from pypdf import PdfReader
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter

docs = [Document(page_content=p.extract_text() or "", metadata={"page": i})
        for i, p in enumerate(PdfReader("manual-de-politicas.pdf").pages)]

splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000, chunk_overlap=200, add_start_index=True)
chunks = splitter.split_documents(docs)
Cada página se vuelve un Document; luego se parte en fragmentos solapados.
Indexar y recuperar
from langchain_openai import OpenAIEmbeddings
from langchain_mongodb import MongoDBAtlasVectorSearch

vectorstore = MongoDBAtlasVectorSearch.from_documents(
    chunks, OpenAIEmbeddings(model="text-embedding-3-small"),
    collection=coleccion, index_name="vector_index")
retriever = vectorstore.as_retriever(search_kwargs={"k": 4})
El retriever devuelve los 4 fragmentos más similares a la consulta.
La cadena RAG de SoporteBot
Reutilizamos el model de la parte 3 y definimos el prompt con el contexto recuperado.
from langchain_core.runnables import RunnablePassthrough
from langchain_core.output_parsers import StrOutputParser

prompt = ChatPromptTemplate.from_messages([
    ("system", "Responde usando solo este contexto:\n\n{contexto}"),
    ("human", "{pregunta}"),
])

rag = (
    {"contexto": retriever, "pregunta": RunnablePassthrough()}
    | prompt | model | StrOutputParser()
)
rag.invoke("¿Cuál es la política de devoluciones?")¿Qué es un agente?
Un agente es un modelo que decide qué herramienta usar y repite el ciclo hasta resolver la tarea. No es una cadena fija: el modelo elige el camino.
Modelo
lee el ticket¿Herramienta?
elige una o respondeEjecutar
consulta el pedidoResultado
vuelve al modeloHerramientas con @tool
Una herramienta es una función con nombre, descripción y argumentos tipados. El modelo las ve como capacidades disponibles.
from langchain.tools import tool

@tool
def consultar_pedido(numero: str) -> str:
    """Devuelve el estado de un pedido por su número."""
    return "Pedido #12345: en tránsito, llega mañana."

@tool
def buscar_en_manual(consulta: str) -> str:
    """Busca en el manual de políticas de la tienda."""
return retriever.invoke(consulta)[0].page_contentEl modelo pide herramientas: bind_tools
from langchain.tools import tool
from langchain.chat_models import init_chat_model

@tool
def consultar_pedido(numero: str) -> str:
    """Devuelve el estado de un pedido."""
    return "en tránsito"

model = init_chat_model("gpt-5-nano", model_provider="openai")
model_con_tools = model.bind_tools([consultar_pedido])

resp = model_con_tools.invoke("¿Dónde está mi pedido #12345?")
resp.tool_calls  # [{'name': 'consultar_pedido', 'args': {'numero': '12345'}}]
El modelo pide la herramienta; ejecutarla y devolver el resultado sigue siendo tu trabajo. Eso es justo lo que automatiza create_agent.
create_agent: el bucle completo
from langchain.agents import create_agent

agente = create_agent(
    model=model,
    tools=[consultar_pedido, buscar_en_manual],
    system_prompt="Eres el soporte de TiendaPiura. No inventes datos.",
)

agente.invoke({"messages": [
    {"role": "user", "content": "¿Dónde está mi pedido #12345?"},
]})Qué pasa por dentro
La conversación del agente es una secuencia de mensajes. Los roles assistant y tool hacen el trabajo:
Varias herramientas y streaming
agente = create_agent(
    model=model,
    tools=[consultar_pedido, buscar_en_manual, crear_reembolso],
    system_prompt="Eres el soporte de TiendaPiura.",
)

for paso in agente.stream(
    {"messages": [{"role": "user", "content": "Quiero devolver #12345"}]},
):
    for m in paso.get("messages", []):
        print(type(m).__name__, getattr(m, "tool_calls", ""))
Con más herramientas, el modelo decide cuál usar. El streaming muestra los pasos en vivo.
Memoria entre turnos
Un checkpointer guarda el estado y thread_id identifica la conversación de cada cliente.
from langgraph.checkpoint.memory import InMemorySaver

agente = create_agent(
    model=model,
    tools=[consultar_pedido],
    checkpointer=InMemorySaver(),
)

config = {"configurable": {"thread_id": "cliente-ana"}}
agente.invoke({"messages": [{"role": "user", "content": "Hola, soy Ana."}]}, config)
agente.invoke({"messages": [{"role": "user", "content": "¿Recuerdas mi nombre?"}]}, config)Aprobar acciones sensibles
El middleware envuelve el bucle del agente. HumanInTheLoopMiddleware exige aprobación antes de una acción crítica.
from langchain.agents.middleware import HumanInTheLoopMiddleware

agente = create_agent(
    model=model,
    tools=[consultar_pedido, crear_reembolso],
    middleware=[
        HumanInTheLoopMiddleware(
            interrupt_on={"crear_reembolso": {"allowed_decisions": ["approve", "reject"]}},
        ),
    ],
)
También hay middleware de resumen de historial y de PII.
Agentic RAG: buscar es una herramienta
from langchain.tools import tool

@tool
def buscar_en_manual(consulta: str) -> str:
    """Busca en el manual de políticas de la tienda."""
    docs = retriever.invoke(consulta)
    return "\n\n".join(d.page_content for d in docs)

agente = create_agent(
    model=model,
    tools=[buscar_en_manual, consultar_pedido],
    system_prompt="Consulta el manual antes de responder políticas.",
)
Diferencia: en el 2-step RAG siempre se busca; aquí el agente decide si necesita el manual.
Cadena o agente: cuándo usar cada uno
Predecible, rápido y barato. Ideal para FAQs, clasificar o RAG simple. Usa una cadena por defecto.
Flexible para tareas abiertas con varias herramientas. Más latencia y coste; necesita control y evaluación.
SoporteBot, de principio a fin
Responde al ticket con un prompt con variables.
Clasifica el ticket y extrae datos con Pydantic.
Responde con el manual de políticas.
Consulta pedidos, con memoria y control humano.
Todo en seis líneas
model  = init_chat_model("openai:gpt-5-nano")            # 1. modelo
prompt = ChatPromptTemplate.from_messages([...])         # 2. prompt
chain  = prompt | model | StrOutputParser()              # 3. cadena (pipe)
ticket = model.with_structured_output(Ticket)            # 4. datos validados
rag    = {"contexto": retriever, "pregunta": RunnablePassthrough()} | prompt | model | StrOutputParser()  # 5. RAG
agente = create_agent(model=model, tools=[consultar_pedido]) # 6. agenteRecursos
Guías, tutoriales y referencia de la API.
Cursos gratuitos de fundamentos y agentes.
Trazas para depurar tus cadenas y agentes.
Talleres y proyectos colaborativos en la región.