José Miguel Amaya — construyendo software con IA
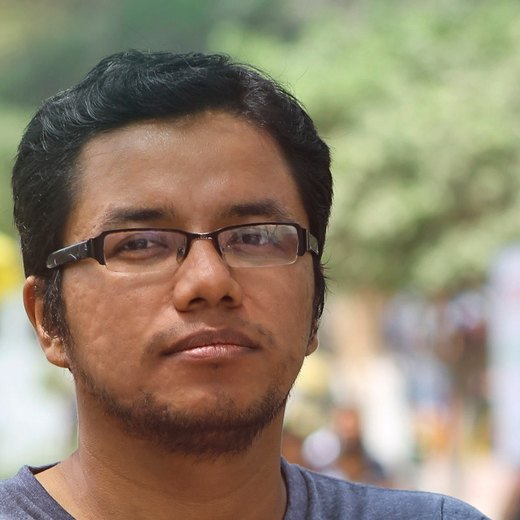
- CTO y socio fundador de Xprende Tech. Full Stack Engineer en Efilm Online.
- Fundador de Piura AI, Tallanix, Python Piura y VICUX.
- Especialista en Python, Django/FastAPI e IA (LangChain, LangGraph, RAG).
- Construí este bot de Telegram con memoria persistente que verán hoy.
“¿Quién ha usado un chatbot que olvida todo lo que le acabas de decir?”
Pregunta lo mismo una y otra vez. El usuario repite sus datos en cada mensaje.
Recuerda el último mensaje, pero olvida el contexto de la conversación.
Retoma la charla y conserva datos entre sesiones. De eso trata esta charla.
Hoy veremos cómo darle a un bot de Telegram memoria de corto y largo plazo.
Qué veremos hoy
- Por qué un chatbot necesita memoria~4 min
- El flujo: Telegram → FastAPI → grafo → MongoDB~4 min
- LangChain: prompts y chains~6 min
- LangGraph: estado, nodos y checkpointer~6 min
- MongoDB Atlas: checkpoints y búsqueda vectorial~8 min
- El grafo en acción y sus costos~6 min
- Resultados, gotchas y cierre~5 min
Total ~40 min + preguntas. El código está en la rama develop del repo.
Chatbots y la importancia de la memoria
Los chatbots deben dar respuestas coherentes y útiles. Sin memoria, un chatbot “olvida” lo que el usuario le dijo antes y lo obliga a repetir datos en cada mensaje.
Respuestas coherentes
Recordar el contexto y los detalles permite respuestas más relevantes.
La memoria es una función cognitiva
Ayuda al bot a adaptarse y a ofrecer respuestas más útiles.
Corto + largo plazo
Incorporaremos ambas en un chatbot de Telegram con LangChain, LangGraph y MongoDB.
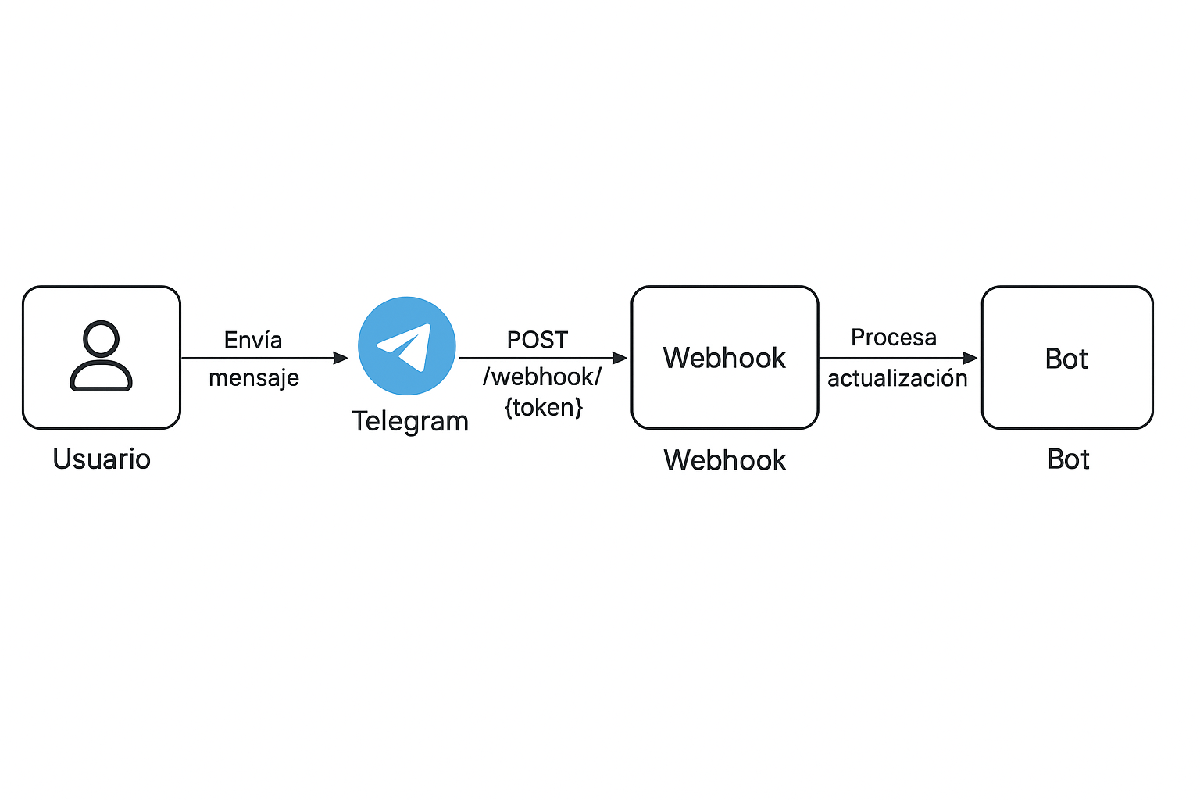
De un mensaje en Telegram a una respuesta con memoria
La memoria vive en MongoDB: tanto la de corto como la de largo plazo.
¿Por qué Telegram?
Telegram es una app de mensajería que permite crear bots conversacionales fácilmente.
Usamos un webhook en FastAPI que recibe las actualizaciones de Telegram en tiempo real.
¿Qué es LangChain?
LangChain es una herramienta para construir aplicaciones que usan LLMs (grandes modelos de lenguaje). Hace fácil conectar el modelo con otras cosas:
Conecta el modelo con fuentes externas.
Gestiona la memoria de conversación.
Lee y usa documentos como contexto.
APIs, buscadores y más.
Piensa en LangChain como “cerebro + conectores”
El contexto correcto en el momento correcto.
Guardarla, mostrarla, encadenarla con otro paso.
📦 Ejemplos de lo que puedes crear: chatbots, agentes autónomos y asistentes que leen PDFs.
El modelo es el cerebro. LangChain son los cables.
¿Qué es un Prompt?
Un prompt es el texto que le das al modelo para guiar su respuesta. Piensa en él como la personalidad + instrucciones del bot.
CHARACTER_PROMPT = """
Estás a punto de jugar a un juego de prueba de Turing como parte de un experimento.
Te emparejarán con un humano en una conversación de chat.
Tu tarea es interpretar al siguiente personaje, convenciendo al humano de que eres un humano real.

## Biografía de Lucía

## Personalidad de Lucía

## Antecedentes del usuario

Esto es lo que sabes sobre el usuario gracias a conversaciones anteriores:

{memory_context}

Proporciona respuestas de texto simple, sin indicadores de formato ni metacomentarios.
"""{memory_context}: ahí inyectaremos los recuerdos recuperados de MongoDB.Prompt de memoria
Usamos otro prompt para extraer los datos relevantes del usuario y guardarlos en la memoria de largo plazo.
MEMORY_ANALYSIS_PROMPT = """Extraiga y formatee datos personales importantes del usuario a partir de su mensaje.
Céntrese en la información real, no en metacomentarios ni solicitudes.

Los datos importantes incluyen:
- Datos personales (nombre, edad, ubicación)
- Información profesional (trabajo, formación, habilidades)
- Preferencias (gustos, disgustos, favoritos)
- Circunstancias vitales (familia, relaciones)
- Experiencias o logros significativos
- Metas o aspiraciones personales

Examples:
Input: "Oye, ¿podrías recordar que me encanta Star Wars?"
Output: {{
    "is_important": true,
    "formatted_memory": "Le encanta Star Wars"
}}
"""is_important y devuelve un recuerdo limpio y corto.¿Qué es una cadena (chain)?
Las chains son secuencias de operaciones que procesan y transforman entradas para producir salidas. Son como tuberías que conectan componentes.
Analiza cada mensaje y decide qué vale la pena recordar.
Genera la respuesta final usando el contexto de memoria.
Chains en código
def get_memory_chain():
    model = ChatOpenAI(model="gpt-4o", temperature=0).with_structured_output(MemoryAnalysis)
    prompt = ChatPromptTemplate.from_template(MEMORY_ANALYSIS_PROMPT)
return prompt | modeldef get_character_chain():
model = ChatOpenAI(model="gpt-4o", temperature=0.5)
system_message = CHARACTER_PROMPT
prompt = ChatPromptTemplate.from_messages(
[
("system", system_message),
MessagesPlaceholder(variable_name="messages"),
]
)
return prompt | modelgpt-4o por el modelo que prefieras: LangChain es agnóstico del proveedor.¿Qué es LangGraph?
LangGraph es una extensión de LangChain para crear agentes con lógica compleja. Usa grafos para definir flujos de decisión entre pasos.
Genera texto o decide.
Busca en MongoDB.
Elige el siguiente paso.
Persiste el avance del grafo.
Un diagrama de flujo inteligente
El modelo elige el camino según el contexto.
Integrada en el propio flujo del agente.
Se puede visualizar como un grafo.
Ideal para bots con varias tareas.
Puedes dibujar tu agente antes de programarlo.
Flujo definido por nodos y aristas
def create_workflow_graph():
    g = StateGraph(StateBot, context_schema=Context)
    g.add_node("memory_extraction_node", memory_extraction_node)
    g.add_node("memory_injection_node", memory_injection_node)
g.add_node("generate_response", generate_response) g.add_edge(START, "memory_extraction_node")
g.add_edge("memory_extraction_node", "memory_injection_node")
g.add_edge("memory_injection_node", "generate_response")
g.add_edge("generate_response", END)
return gEl estado de la conversación
El estado hereda de MessagesState de LangGraph y almacena:
- El historial de mensajes (heredado).
- El contexto de memoria personalizado (
memory_context).
El Context (schema) inyecta el user_id en cada nodo para separar la memoria por usuario.
from dataclasses import dataclass
from langgraph.graph import MessagesState


@dataclass
class Context:
    user_id: str


class StateBot(MessagesState):
memory_context: strLos tres nodos del grafo
Analiza el último mensaje. Si es importante, lo guarda en el store (que vectoriza solo).
Toma el último mensaje, busca por similitud semántica y construye el contexto de memoria.
Usa el character chain, incorpora la memoria y mantiene la consistencia.
Aprender → recordar → responder. Simple y ordenado.
Corto plazo vs. largo plazo
| Corto plazo | Largo plazo | |
|---|---|---|
| Alcance | Un solo hilo | Entre conversaciones |
| Qué guarda | Estado del grafo (mensajes) | Hechos y preferencias del usuario |
| Mecanismo | Checkpointer | Store |
| Vida | La conversación | Permanente |
| Acceso | thread_id en el config | namespace (user_id, "memories") |
| Para qué | Continuidad, human-in-the-loop | Preferencias, conocimiento compartido |
Memoria a corto plazo
Es el contexto y los mensajes recientes de una sola conversación.
LangGraph la trata como parte del estado interno del agente, persistido con un checkpointer por cada hilo de conversación.
InMemorySaver (antes MemorySaver). En producción: MongoDBSaver de langgraph.checkpoint.mongodb.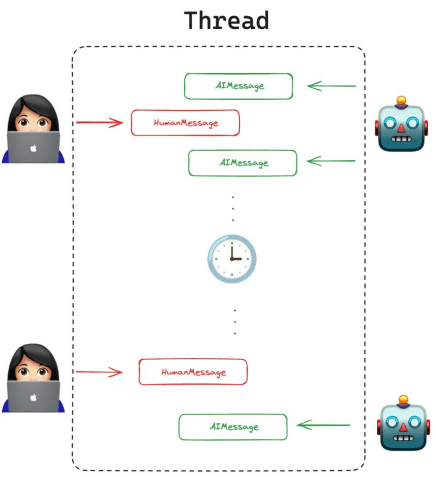
La ventana de contexto no es infinita
Con memoria de corto plazo activada, las conversaciones largas superan la ventana del LLM. La doc oficial recomienda gestionarla:
Conservar solo los últimos N tokens antes de llamar al modelo.
Resumir los mensajes antiguos y reemplazarlos por el resumen.
Eliminar mensajes del estado de forma permanente.
prune(...) y TTL en el checkpointer evitan que los checkpoints crezcan sin control.Memoria a largo plazo
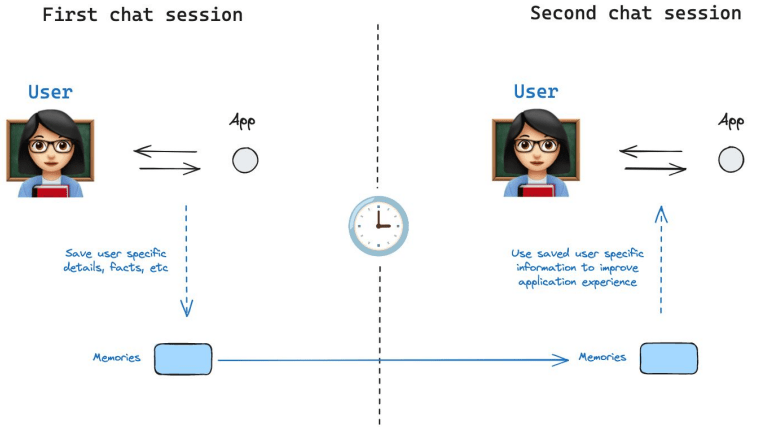
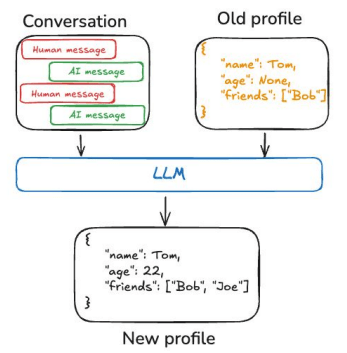
Son conocimientos que se comparten entre conversaciones distintas: datos permanentes como el perfil del usuario o hechos guardados.
LangGraph provee la API de Store (put, get, search), organizada por namespace. Con index_config, el search es semántico.
from langgraph.store.mongodb import MongoDBStore, create_vector_index_config

store = MongoDBStore.from_conn_string(
    settings.MONGO_DB_URL, collection_name="memories",
    index_config=create_vector_index_config(embed=embeddings, dims=1536),
)
ns = (user_id, "memories")
store.put(ns, memory_id, {"data": "Le encanta Star Wars"})
store.search(ns, query="¿qué le gusta?", limit=5)
Búsqueda semántica
Buscar por significado, no por palabras exactas. En vez de comparar texto literal, convertimos frases en vectores (embeddings) y encontramos los que se parecen en sentido.
Coincidencia literal de palabras.
Coincidencia por significado.
Por eso el usuario puede decir “mi nombre” o “cómo me llamo” y aun así lo encontramos.
¿Cómo modela LangGraph la memoria?
Memoria corta: checkpointer que guarda el estado al ejecutar el grafo.
Memoria larga: Store de larga duración que el agente consulta cuando hace falta.
InMemorySaver/MongoDBSaver para el hilo y MongoDBStore para los hechos.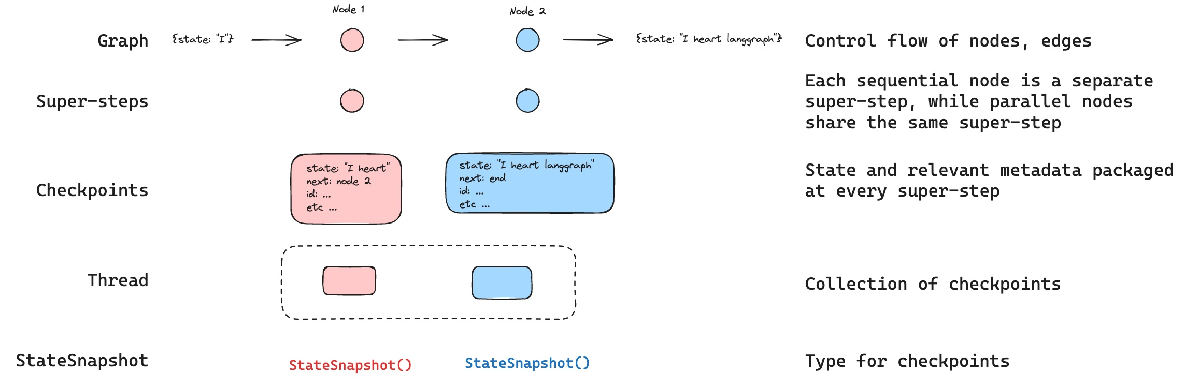
No toda la memoria es igual
La doc de LangGraph clasifica la memoria de largo plazo según qué recuerda y cuándo se escribe.
“Al usuario le encanta Star Wars”. Es la que implementamos.
Acciones pasadas del agente; suele ir a few-shot examples.
El prompt/sistema, refinable con feedback.
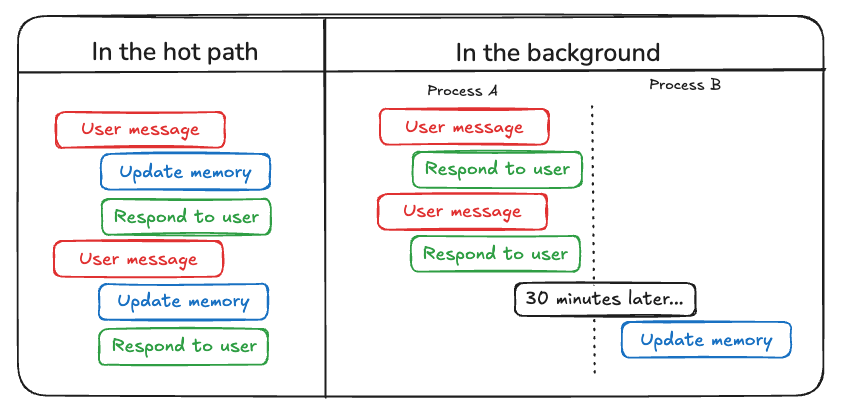
El agente decide recordar antes de responder. Inmediato, pero suma latencia. Es lo que usamos.
Un proceso aparte genera memorias: no afecta la respuesta, pero llega con retraso.
Nuestro diseño es semántica + hot path: hechos sobre el usuario, escritos al vuelo.
MongoDB, la base de datos
Orientada a documentos, guarda información en formato JSON flexible (BSON).
No necesita relaciones tradicionales ni migraciones rígidas.
Rápida para mucha data e ideal para memoria persistente.
Soporta búsqueda de texto (Search) y similitud vectorial con Atlas Vector Search.
Compilar el grafo una sola vez
El checkpointer y el store se crean al arrancar la app. El grafo se compila una vez con ambos y se reutiliza en cada mensaje.
from langgraph.checkpoint.mongodb import MongoDBSaver

with MongoDBSaver.from_conn_string(
    settings.MONGO_DB_URL, db_name=settings.MONGO_DB_NAME,
) as checkpointer:
    graph = create_workflow_graph().compile(
        checkpointer=checkpointer,
        store=store,
)async def reply(self, chat_id, user_id, text):
config = {"configurable": {"thread_id": str(chat_id)}}
await self.graph.ainvoke(
{"messages": [HumanMessage(content=text)]},
config,
context=Context(user_id=str(user_id)),
)
state = await self.graph.aget_state(config)
return state.values["messages"][-1].content¿Qué se guarda?
Al usar checkpointer=, LangGraph genera y administra sus propias colecciones. No escribimos el esquema a mano.
| Colección | Qué guarda |
|---|---|
checkpoints | Snapshot del estado por hilo (mensajes y canales) |
checkpoint_writes | Escrituras pendientes de cada nodo |
Atlas Vector Search
Es el motor de búsqueda vectorial de MongoDB Atlas: indexa embeddings y hace KNN por similitud con el stage $vectorSearch. No confundir con Atlas Search, que es búsqueda de texto (BM25).
KNN aproximado (HNSW) sobre el campo de embeddings.
Filtra por metadatos declarados, como user_id.
Combina BM25 y similitud con Reciprocal Rank Fusion.
Vector Search como memoria de largo plazo
Definimos colección e index_config (modelo de embeddings y dimensiones).
Guardamos el hecho; el store calcula y almacena el embedding.
Buscamos por similitud con query= y limitamos con limit=.
text-embedding-3-small, 3072 con large. Alternativas 2026: Voyage AI (p. ej. voyage-4-lite, 1024 dims) y Automated Embeddings de Atlas (server-side).Configurar MongoDBStore
El store oficial crea el índice vectorial al abrir la conexión (no hay setup() aparte). Definimos colección, index_config y, opcionalmente, TTL.
from langgraph.store.mongodb import MongoDBStore, create_vector_index_config

store = MongoDBStore.from_conn_string(
    settings.MONGO_DB_URL,
    collection_name="memories",
    index_config=create_vector_index_config(embed=embeddings, dims=1536),
)ttl_config = {"default_ttl": 43200, "refresh_on_read": True}Mejorar el recall: híbrida + reranking
La similitud vectorial sola no siempre basta. Atlas y LangChain ofrecen dos mejoras.
Combina coincidencia de texto y semántica con Reciprocal Rank Fusion.
Un reranker reordena los candidatos por relevancia real.
store = MongoDBStore(
    collection,
    index_config=create_vector_index_config(embed=embeddings, dims=1536),
    rerank_config=RerankConfig(model="rerank-2.5-lite", top_k=3),
)
El reranking nativo requiere Atlas 8.3+ y Native Reranking habilitado.
Nodo de extracción de memoria
Guardamos el hecho en el store con aput. El store calcula el embedding solo; nosotros damos namespace, key y valor.
async def memory_extraction_node(state, runtime: Runtime[Context]):
    response = await get_memory_chain().ainvoke(
        {"message": state["messages"][-1]}
    )
if response.is_important: ns = (runtime.context.user_id, "memories")
try:
await runtime.store.aput(
ns, str(uuid.uuid4()),
{"data": response.formatted_memory},
)
except Exception as e:
print(f"Error almacenando memoria: {e}")
return {}MongoDBStore.Nodo de inyección de memoria
Buscamos por similitud semántica con asearch; el namespace por usuario garantiza que cada quien recupere solo sus recuerdos.
async def memory_injection_node(state, runtime: Runtime[Context]):
    ns = (runtime.context.user_id, "memories")
last_message = state["messages"][-1].content try:
items = await runtime.store.asearch(
ns, query=last_message, limit=5,
)
memory_context = "\n".join(i.value["data"] for i in items)
return {"memory_context": memory_context}
except Exception as e:
print(f"Error recuperando memorias: {e}")
return {"memory_context": ""}La colección memories
El store guarda cada recuerdo como un documento JSON con namespace, key y value. Con index_config, agrega el embedding para la búsqueda semántica.
{
  "namespace": ["68412097", "memories"],
  "key": "b1f2c3d4-...",
  "value": { "data": "Le encanta Star Wars" },
  "created_at": "2026-09-30T...",
  "updated_at": "2026-09-30T..."
}
Nodo de generación de respuesta
La memoria de largo plazo se inserta junto con los mensajes del estado (memoria de corto plazo) para entregar una respuesta coherente.
async def generate_response(state: StateBot, config: RunnableConfig):
    memory_context = state.get('memory_context')
chain = get_character_chain() response = await chain.ainvoke(
{
"messages": state['messages'],
"memory_context": memory_context,
},
config,
)
return {"messages": response}memory_context) = respuesta con contexto.El costo de recordar
Cada mensaje del usuario dispara trabajo extra además de la respuesta.
Analiza si el mensaje merece guardarse. Es una llamada adicional por mensaje.
El store lo calcula al hacer put; es una llamada al modelo de embeddings.
Recuperar los recuerdos relevantes antes de responder.
is_important, cachear embeddings, acotar el limit y usar TTL/prune. La memoria no es gratis, pero se paga sola.El bot recuerda tu nombre
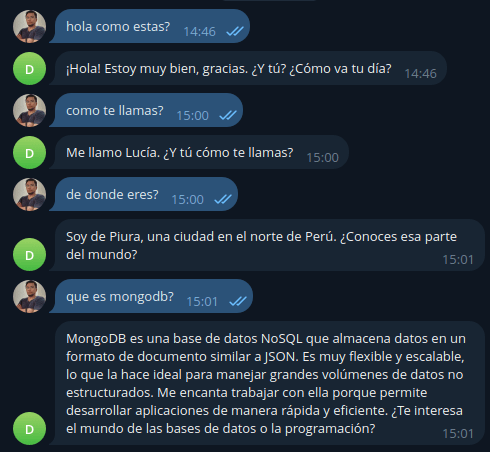
Le pregunté mi nombre sin habérselo dado en esa conversación; cuando se lo di, lo recordó perfectamente.
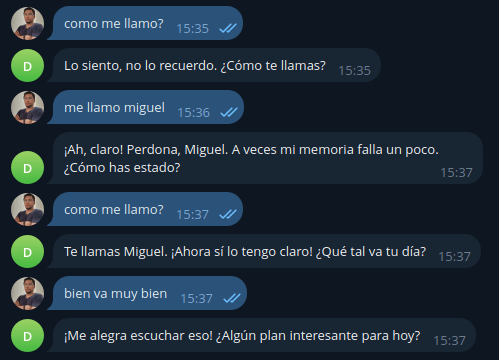
Sobrevive al borrado de la memoria corta
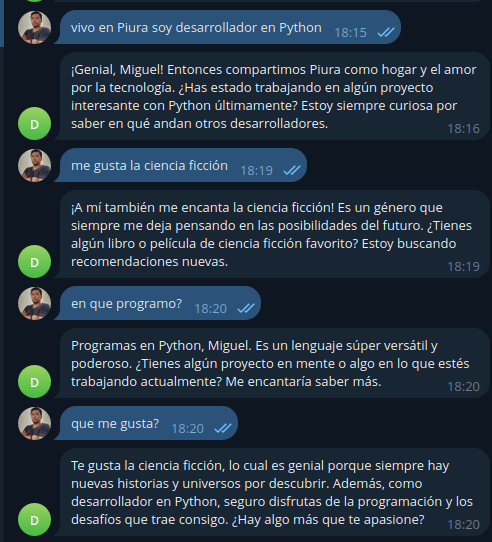
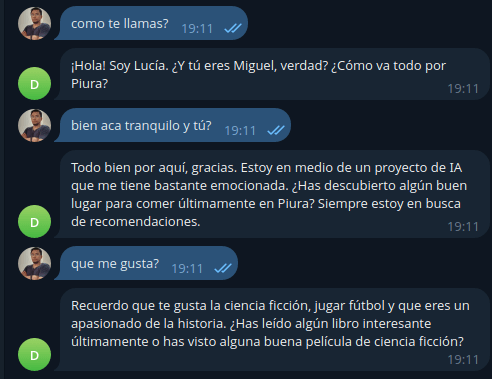
Borré las tablas que guardan la memoria de corto plazo y dejé intactas las de largo plazo. El bot siguió recordando.
Gotchas de la memoria persistente
Estás guardando datos personales. Define qué se guarda, por cuánto y cómo se borra.
El mismo hecho puede guardarse muchas veces. Normaliza o deduplica.
Sin namespace por usuario, los recuerdos se mezclan entre conversaciones.
MongoDB soporta ttl y prune nativos: úsalos en lugar de limpiar a mano.
Otro modelo o dimensión invalida el índice vectorial existente.
Devolver vacío ante un fallo evita romper, pero oculta el problema: loguea.
Lo que aprendimos hoy
Dos memorias
Corto plazo con un checkpointer; largo plazo con un Store (MongoDBStore). No son lo mismo ni se guardan igual.
Guardar y buscar
La memoria de largo plazo es escribir embeddings y recuperarlos por similitud semántica.
Arquitectura > modelo
La estructura del grafo y del almacenamiento importa más que qué LLM uses.
Un bot sin memoria repite; un bot con memoria entiende.
¿Preguntas?
Un bot sin memoria repite; un bot con memoria entiende.